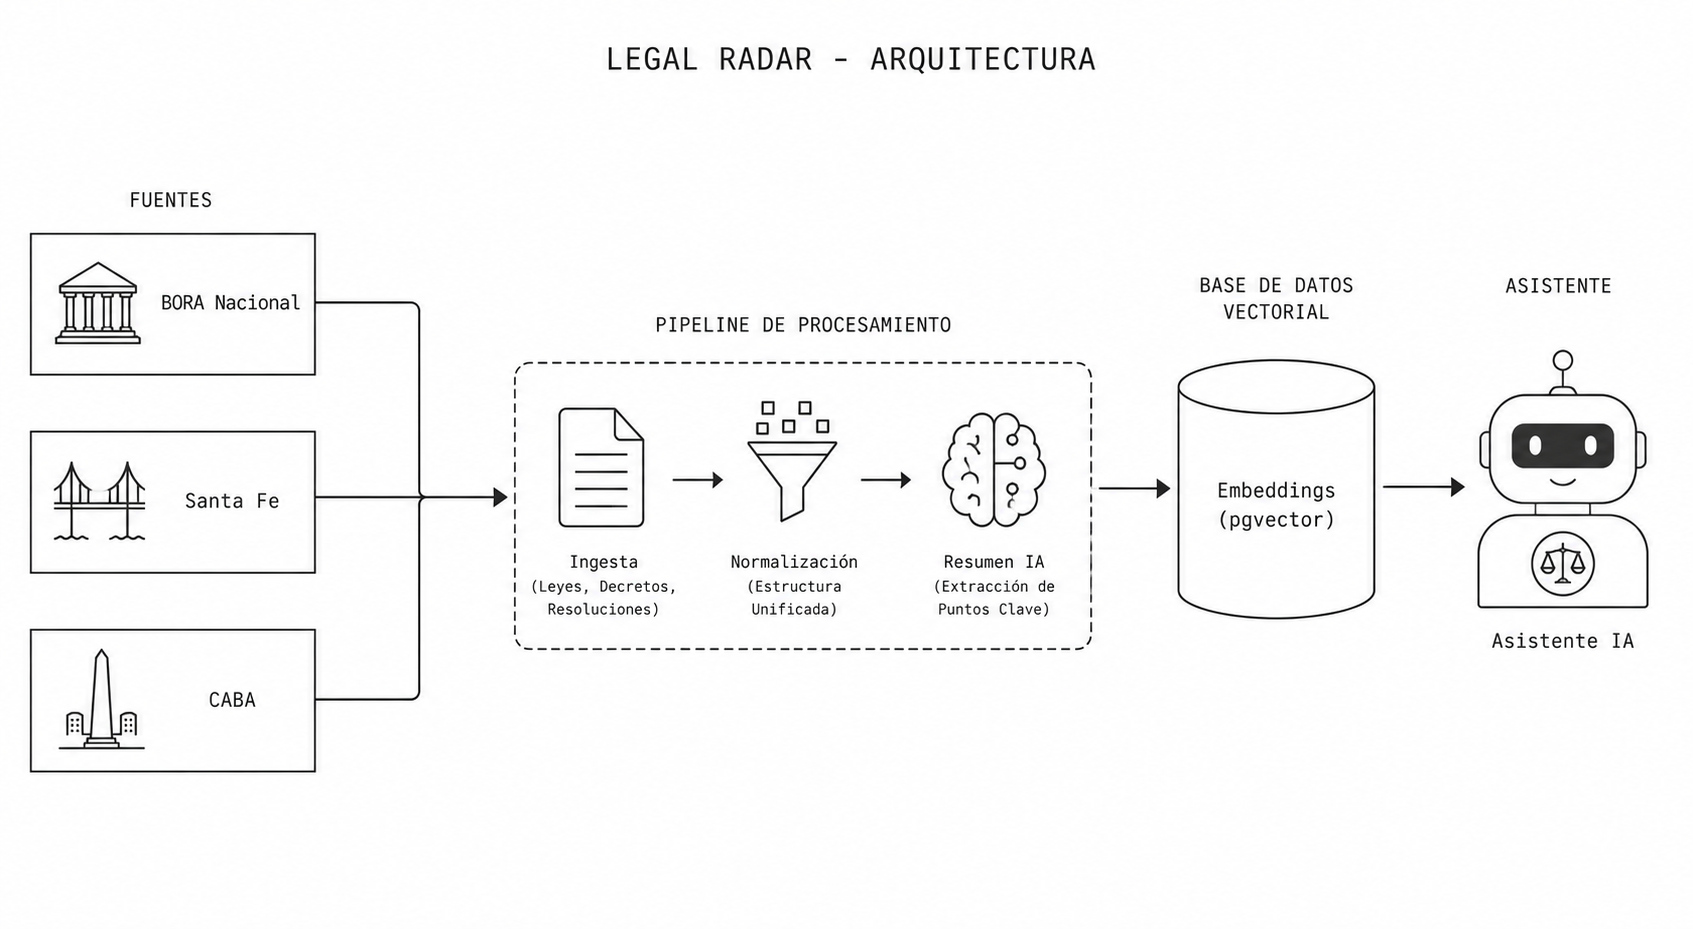
El Radar Legal es el módulo de Legio que vigila los boletines oficiales argentinos, los resume con inteligencia artificial y los deja disponibles para que un abogado —o el asistente IA— encuentre en segundos qué se publicó sobre un tema. Este artículo abre la caja negra: cómo está construido, por qué cada boletín se trabaja de forma distinta, y qué hay detrás de la búsqueda "por significado".
El problema
Los boletines oficiales son la fuente primaria del derecho positivo: ahí se publican leyes, decretos, resoluciones y disposiciones que entran en vigencia. Pero cada jurisdicción los publica de una manera distinta, y ninguna pensó en que un programa los fuera a leer. Algunos exponen una API, otros solo un PDF de 60 páginas, otros una página web. El desafío no es jurídico: es de ingeniería de datos.
El Radar resuelve esto con un principio simple: no importa cómo venga la fuente, todo termina convertido en una lista uniforme de normas —con tipo, número, organismo, un resumen y un link al documento original— que se guarda, se resume y se indexa para búsqueda semántica.
Tres fuentes, tres técnicas
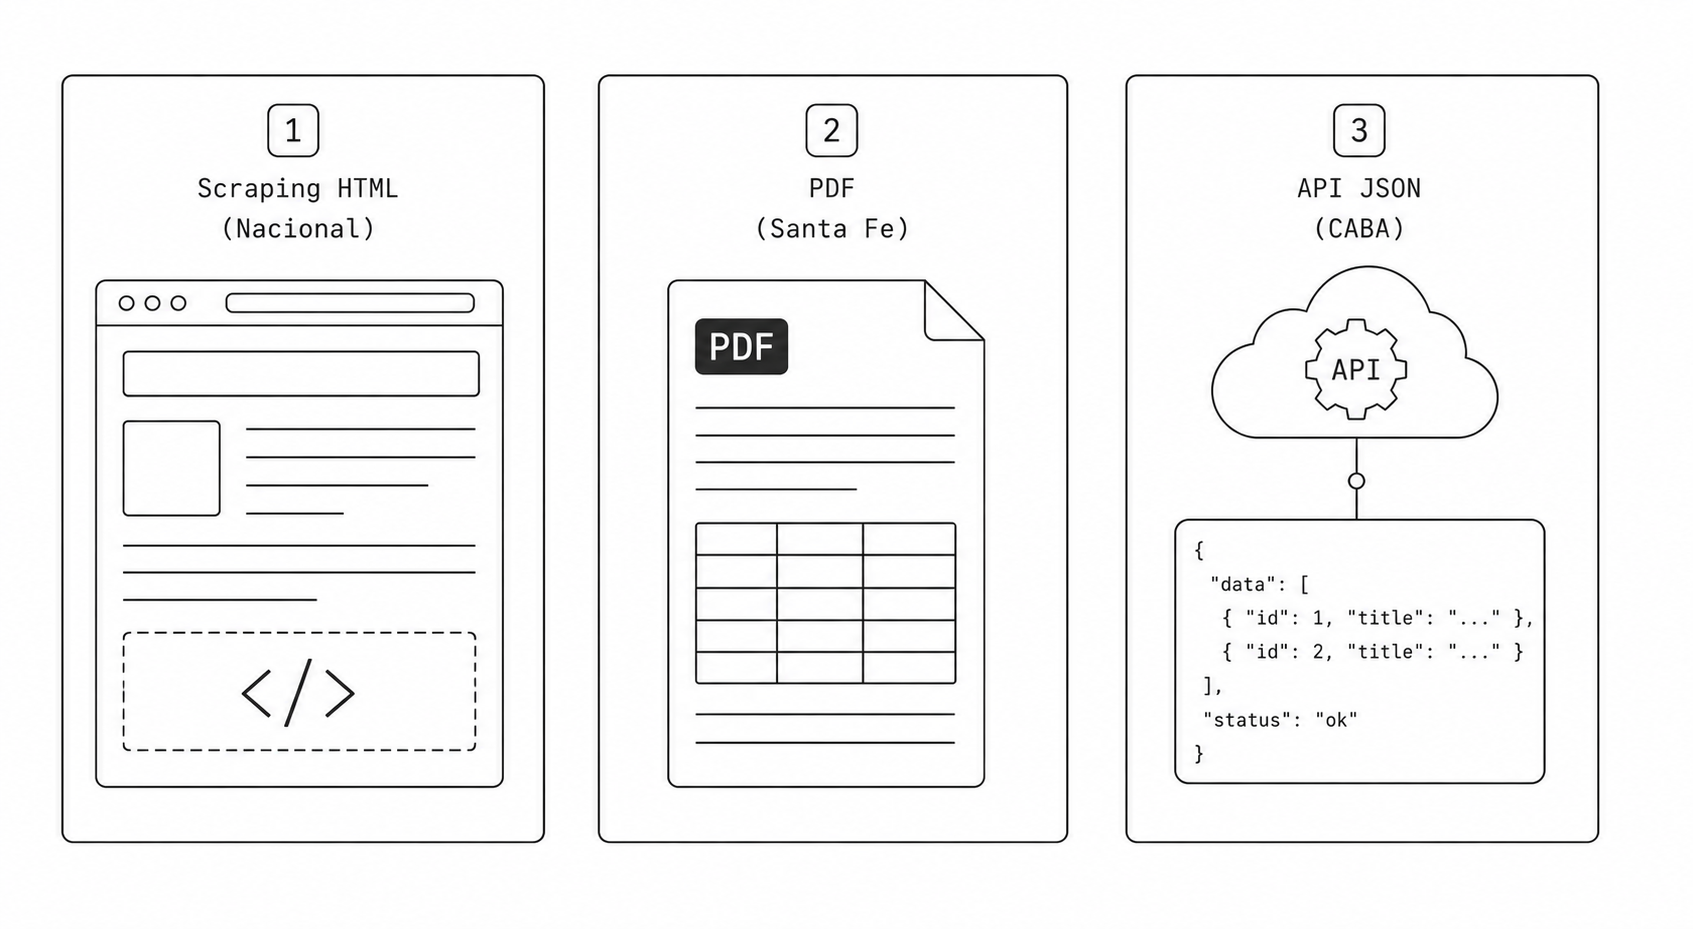
Cada boletín expone los datos distinto, así que cada uno usa la técnica que mejor encaja.
BORA Nacional — scraping HTML
El Boletín Oficial de la República Argentina no ofrece una API para su listado diario. Pero la página de la Primera Sección viene server-rendered: el HTML ya trae el listado completo, agrupado en subsecciones (Decretos, Resoluciones, Disposiciones, Avisos Oficiales, Remates…). Lo recorremos con un parser HTML (cheerio) y nos quedamos solo con las subsecciones normativas —Leyes, Decretos y Resoluciones—, descartando avisos, remates y edictos.
Un detalle importante: el listado de Nación no trae una descripción de cada norma
(las resoluciones solo muestran un código interno como RESOL-2026-389-APN-ANAC#MEC).
Por eso, por cada norma entramos a su página de detalle, extraemos el texto completo del
decreto o resolución, y lo resumimos con IA en una oración. Así, una resolución que
en el listado era ilegible queda como: "Prorroga por treinta días los plazos para la
adecuación de los Centros de Revisión Periódica de Cilindros de GNC a la Norma NAG-444."
BORA Santa Fe — scraping HTML por sección
Santa Fe no tiene API, pero su sitio publica el boletín del día como páginas HTML: hay
una página índice por fecha que enlaza cada sección. Y lo mejor: cada ley y cada decreto
es un archivo individual (por ejemplo ley14445.html, decreto1257.html) que ya trae un
sumario oficial y un enlace a la norma completa.

El flujo:
- Leer el índice del día y quedarnos con los enlaces a las secciones normativas (leyes, decretos) y a "Avisos Oficiales".
- Por cada ley/decreto, entrar a su página y extraer tipo, número, sumario y enlace —sin IA, porque la estructura ya es limpia—. Las leyes se enriquecen con la "Descripción" oficial del Sistema de Información de Normativa de la provincia.
- Las resoluciones administrativas viven dentro de "Avisos Oficiales": las detectamos
por su encabezado formal (
RESOLUCIÓN Nº … SANTA FE, fecha), descartando las que solo están citadas dentro de otro texto.
Antes, Santa Fe era un PDF de 60 páginas que había que trocear y mandar a la IA en un pipeline map→reduce para que extrajera las normas. El enfoque HTML es más confiable, más rápido y no gasta tokens de IA en la extracción.
BORA CABA — API JSON
La Ciudad de Buenos Aires es la más amable: expone una API REST que devuelve el boletín ya clasificado en una jerarquía de Poder → Tipo → Repartición, con el tipo, el organismo emisor y un sumario de cada norma. No hace falta IA para clasificar: solo navegamos la estructura y filtramos lo que no es normativa.
CABA publica mucho (un día puede traer 270+ resoluciones y disposiciones de trámite), así que por ahora nos quedamos solo con Leyes y Decretos, lo de mayor jerarquía.
El paso común: resumen del día
Una vez que cada fuente devolvió su lista de normas, generamos con IA un resumen ejecutivo del día —dos o tres oraciones, más los puntos destacados y las áreas del derecho afectadas— y lo guardamos junto con las normas. Es lo que el abogado ve de un vistazo al abrir el Radar.
La parte interesante: RAG y embeddings
Guardar las normas es la mitad del trabajo. La otra mitad es que el asistente IA pueda responder preguntas como "¿salió algo sobre tarifas de gas esta semana?" sin que el abogado tenga que adivinar la palabra exacta.
¿Qué es un embedding?
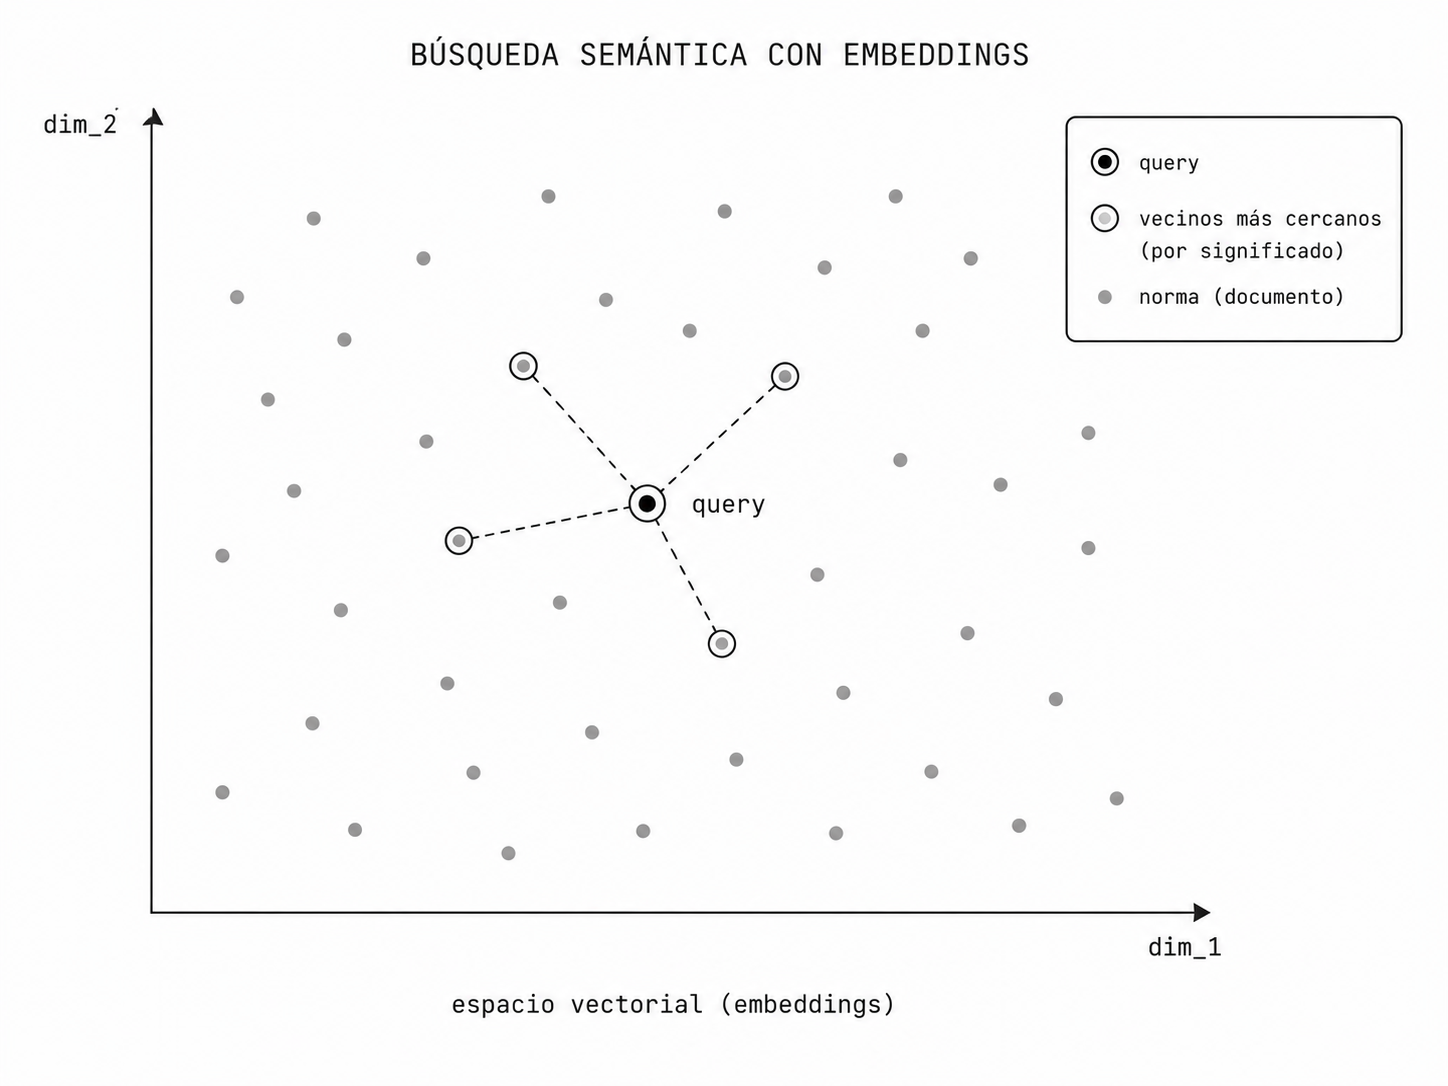
Un embedding es una representación numérica del significado de un texto: un vector de cientos de números. Dos textos que hablan de lo mismo —aunque usen palabras distintas— quedan "cerca" en ese espacio. "Tarifas de gas" y "adecuación de la Norma NAG-444 de GNC" no comparten ninguna palabra, pero su significado está relacionado, y sus vectores quedan próximos.
Cómo lo usamos (RAG)
RAG (Retrieval-Augmented Generation) es la técnica de recuperar los documentos relevantes y dárselos a la IA para que responda con base en ellos, en vez de inventar. En el Radar funciona así:
- Al ingerir: por cada norma (y cada fallo de jurisprudencia) generamos su embedding
y lo guardamos en una tabla con índice vectorial (
pgvector). La unidad es atómica: un embedding por norma, no por boletín entero. Así una norma puntual matchea fuerte y con su propio link. - Al consultar: cuando el abogado pregunta algo, convertimos su pregunta en un embedding y buscamos las normas más cercanas por distancia coseno. Las que más se parecen en significado vuelven primero.
- Al responder: el asistente recibe esas normas (con fuente, fecha y link) y arma la respuesta citándolas.
El resultado: el abogado pregunta en lenguaje natural y el asistente le trae la norma exacta con el enlace al texto oficial, aunque no haya usado ni una de las palabras del título.
Honestidad sobre los límites
- Confiabilidad: las tres fuentes son hoy bastante estables (API en CABA, HTML en Nación y Santa Fe). El riesgo es que cambien su HTML o su API y haya que adaptar el parser.
- Solo normativa: por decisión de producto, hoy se ignoran licitaciones, edictos y avisos. Son datos válidos pero de otro universo; podrían sumarse como categoría aparte.
- Fragilidad del scraping: si las fuentes cambian su HTML o su API, hay que adaptar el parser. Es el costo de no tener un estándar común entre jurisdicciones.
En resumen
El Radar Legal es, por debajo, un ejercicio de integración de datos heterogéneos: scraping HTML donde no hay API y consumo de API donde existe —todo normalizado a una estructura común, resumido con IA e indexado para búsqueda semántica. La promesa para el abogado es simple: preguntar en castellano y recibir la norma correcta, con su link, en segundos.